مقدمه: چرا باید به «انرژی» فکر کنیم؟
تصور کنید میخواهید به یک ماشین یاد بدهید که تفاوت بین «گربه» و «سگ» را تشخیص دهد. روش معمول این است که به آن بگویید: «این تصویر را ببین و بگو چیست.» ماشین هم بعد از دیدن هزاران تصویر، یاد میگیرد که بگوید «گربه» یا «سگ». اما یک سؤال بنیادین وجود دارد: آیا ماشین واقعاً میفهمد که این تصویر چقدر با یک گربه سازگار است؟
اینجاست که مدلهای انرژیمحور (Energy-Based Models) یا به اختصار EBM وارد میشوند. ایدهی آنها ساده اما عمیق است: بهجای اینکه ماشین مستقیماً بگوید «این گربه است»، به هر ترکیب از ورودی و خروجی یک عدد نسبت میدهیم که میزان سازگاری آنها را نشان میدهد. این عدد را انرژی (Energy) مینامیم.
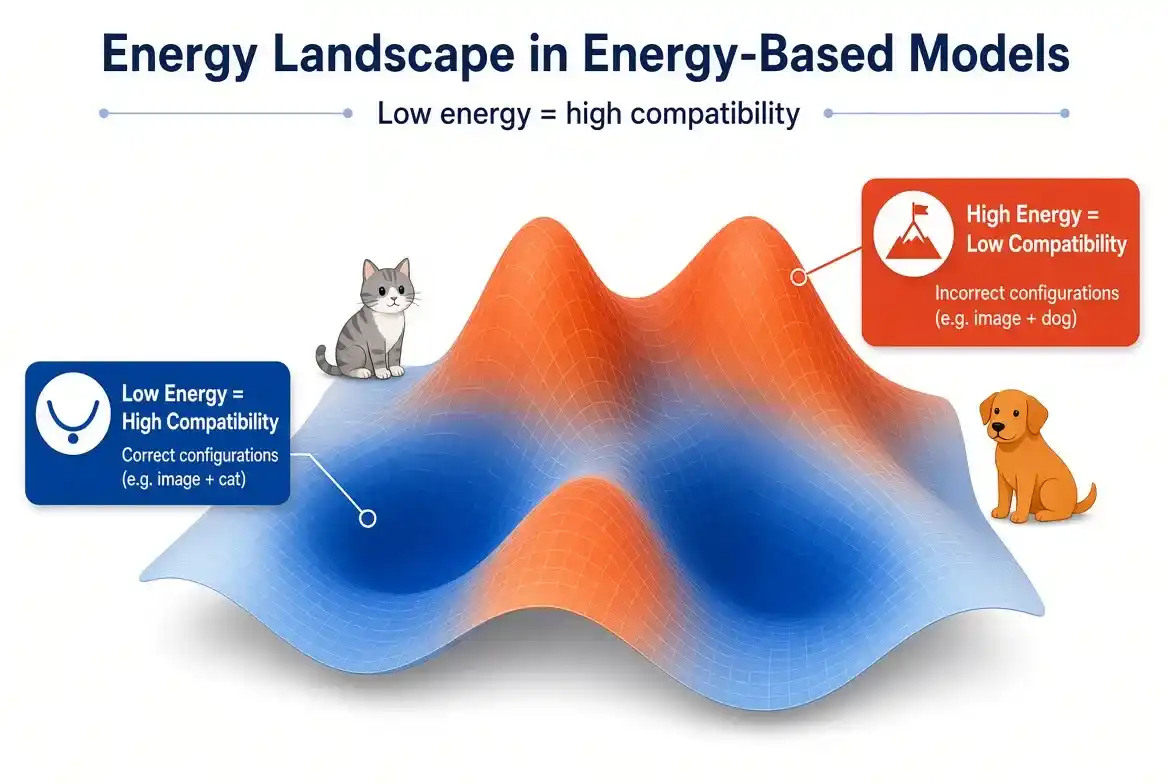
انرژی پایین = سازگاری بالا
انرژی بالا = سازگاری پایین
پس ماشین بهجای اینکه صرفاً یک برچسب را تولید کند، میتواند بگوید: «ترکیب این تصویر با برچسب گربه، انرژی ۰.۲ دارد و با برچسب سگ، انرژی ۸.۵ دارد؛ بنابراین گربه سازگارتر است.»
این تغییر نگاه، دریچهای به دنیایی باز میکند که در آن تصمیمگیری، یادگیری، متغیرهای پنهان و استنتاج کارآمد همگی میتوانند در یک چارچوب انرژیمحور بررسی شوند.
بخش اول: تابع انرژی — قلب تپنده EBM
۱.۱ تعریف ساده اما قدرتمند
فرض کنید دو مجموعه متغیر داریم: X (ورودی، چیزی که مشاهده میکنیم) و Y (خروجی، چیزی که میخواهیم پیشبینی کنیم). یک تابع انرژی به شکل زیر تعریف میکنیم:
این تابع به هر جفت (x,y) یک عدد حقیقی نسبت میدهد. هرچه این عدد کوچکتر باشد، آن configuration سازگارتر در نظر گرفته میشود.
۱.۲ استنتاج: پیدا کردن بهترین Y
حالا که تابع انرژی را داریم، استنتاج (Inference) یعنی پیدا کردن Yای که کمترین انرژی را داشته باشد:
این یعنی: «از میان همهی Yهای ممکن، حالتی را پیدا کن که با X مشاهدهشده، کمترین انرژی را دارد.»
۱.۳ یادگیری: شکلدادن به چشمانداز انرژی
یادگیری در EBM یعنی پیدا کردن تابع انرژیای که:
- به پاسخهای درست انرژی پایینتر بدهد.
- به پاسخهای نادرست انرژی بالاتر بدهد.
این فرآیند را شکلدادن به چشمانداز انرژی (Energy Landscape) میتوان دید. تصور کنید یک رشتهکوه با درههای عمیق و قلههای بلند. configurationهای مطلوب در نواحی کمانرژی قرار میگیرند و configurationهای نامطلوب در نواحی پرانرژی.
بخش دوم: چهار ستون EBM
لکان در مقالهی A Tutorial on Energy-Based Learning چهار مؤلفهی اصلی را برای ساخت و آموزش یک EBM مطرح میکند:
| مؤلفه | توضیح |
|---|---|
| معماری (Architecture) | ساختار داخلی تابع انرژی E(W, Y, X) |
| الگوریتم استنتاج (Inference) | روشی برای پیدا کردن Y با کمترین انرژی |
| تابع زیان (Loss Function) | معیاری برای شکلدهی مناسب تابع انرژی |
| الگوریتم یادگیری (Learning) | روشی برای پیدا کردن پارامترهای W |
۲.۱ تابع زیان: کدام زیان خوب است؟
همهی توابع زیان یکسان نیستند. برخی ممکن است به فروپاشی (Collapse) منجر شوند؛ یعنی تابع انرژی نتواند تفاوت معناداری میان configurationهای درست و نادرست ایجاد کند. در ادامه مهمترین توابع زیان را مرور میکنیم.
الف) Energy Loss — ساده اما خطرناک
فقط انرژی پاسخ درست را کم میکند. مشکل این است که مکانیزمی برای وادارکردن پاسخهای نادرست به Energy بالاتر ندارد. در برخی معماریهای پرظرفیت، این موضوع میتواند به collapse منجر شود.
ب) Perceptron Loss — بدون حاشیه
این زیان انرژی پاسخ درست را نسبت به بهترین پاسخ پیداشده توسط مدل مقایسه میکند. اما حاشیه (Margin) مشخصی تحمیل نمیکند؛ بنابراین درست و غلط ممکن است تنها اندکی از یکدیگر فاصله داشته باشند.
ج) Margin Losses — با فاصلهی امن
ایده این است که پاسخ درست باید حداقل به اندازهی m از یک پاسخ نادرست مورد توجه، انرژی پایینتری داشته باشد:
که در آن Ȳi یک پاسخ نادرستِ مورد توجه، معمولاً همان Most Offending Incorrect Answer با کمترین Energy است.
Hinge Loss، Log Loss، LVQ2، MCE، Square-Square و Square-Exponential در خانوادهی lossهای margin-based بررسی میشوند.
د) Negative Log-Likelihood (NLL) — نگاه احتمالاتی
این زیان از تفسیر Gibbs-Boltzmann بهدست میآید و در صورت تعریف توزیع احتمال متناظر، به بیشینهکردن احتمال شرطی P(Y|X) مربوط میشود. اما مشکل اصلی، تابع پارتیشن (Partition Function) است؛ یعنی همان انتگرال یا مجموع روی فضای پاسخها که در بسیاری از مسائل بسیار بزرگ یا محاسبهناپذیر است.
بخش سوم: متغیرهای پنهان — وقتی چیزی را نمیبینیم
۳.۱ چرا متغیر پنهان لازم است؟
فرض کنید میخواهیم یک سیستم تشخیص چهره بسازیم. میخواهیم بدانیم «آیا چهره در تصویر وجود دارد؟» (Y) اما موقعیت چهره (Z) را نمیدانیم. این Z یک متغیر پنهان (Latent Variable) است.
تابع انرژی حالا به شکل زیر میشود:
و استنتاج را میتوان بهصورت joint روی Y و Z نوشت:
برای مطالعهی عمیقتر این موضوع میتوانید مقالهی متغیرهای پنهان و مسیر یان لوکان به سوی هوش خودمختار را بخوانید.
۳.۲ انرژی آزاد — حاشیهسازی بهجای کمینهسازی
گاهی اوقات بهجای اینکه فقط بهترین Z را انتخاب کنیم، میخواهیم مقادیر مختلف Z را در نظر بگیریم. اینجا انرژی آزاد (Free Energy) وارد میشود:
در حد دمای صفر، یعنی وقتی β → ∞، این عبارت، تحت شرایط مناسب، به کمینهی Energy روی z نزدیک میشود.
۳.۳ چند پاسخ ممکن برای یک ورودی
یکی از ویژگیهای مهم متغیر پنهان این است که تغییر Z میتواند امکان نمایش چند پاسخ مختلف برای یک X را فراهم کند:
├── Z₁ → Y₁
├── Z₂ → Y₂
├── Z₃ → Y₃
└── Z₄ → Y₄
مثلاً در پیشبینی ویدئو، یک صحنه میتواند چند آیندهی مختلف داشته باشد. در ترجمه، یک جمله میتواند چند ترجمهی درست داشته باشد. بنابراین latent variable میتواند راهی برای نمایش این چندحالتیبودن (Multimodality) باشد.
بخش چهارم: استنتاج کارآمد — گرافهای عاملی
۴.۱ مشکل فضای بزرگ
اگر Y یک تصویر باشد، فضای حالت بسیار بزرگ است. اگر Y یک جمله باشد، تعداد sequenceهای ممکن نیز بسیار زیاد است. چگونه میتوانیم کمینهی انرژی را پیدا کنیم؟
۴.۲ راهحل: تجزیه به فاکتورها
ایدهی گراف عاملی (Factor Graph) این است که انرژی را به مجموع چند فاکتور تجزیه کنیم که هر کدام فقط به زیرمجموعهای از متغیرها وابستهاند:
Ea(X, Z₁)
+ Eb(X, Z₁, Z₂)
+ Ec(Z₂, Y₁)
+ Ed(Y₁, Y₂)
این ساختار میتواند به ما اجازه دهد از برنامهریزی پویا (Dynamic Programming) استفاده کنیم و بهجای بررسی همهی حالتها، مسیرهای بهینه را در یک شبکه (Trellis) بهطور کارآمدتر پیدا کنیم.
۴.۳ الگوریتمهای کلیدی
- Min-Sum Algorithm: برای یافتن کمینهی هزینه در مدلهای ساختاری؛ در زنجیرهها با ایدهی Viterbi مرتبط است.
- Forward Algorithm: برای جمعکردن وزن مسیرها و محاسبهی کمیتهایی مانند تابع پارتیشن در مدلهای مناسب.
- A*: برای جستوجوی هدایتشده در برخی فضاهای حالت بزرگ.
این الگوریتمها بخشی از چیزی هستند که استفاده از EBM را برای مسائل ساختیافته مانند گفتار، دستنویس و توالیها عملیتر میکنند.
بخش پنجم: EBM در برابر مدلهای احتمالاتی
۵.۱ تبدیل انرژی به احتمال
اگر شرایط لازم برای نرمالسازی برقرار باشد، میتوان از انرژی یک توزیع احتمال ساخت:
اما این کار دو چالش اصلی دارد:
- تابع انرژی باید شرایط لازم برای همگرایی و نرمالپذیری را داشته باشد.
- محاسبهی تابع پارتیشن در بسیاری از فضاهای بزرگ بسیار پرهزینه است.
۵.۲ مزیت EBM: نیازی به نرمالسازی برای تصمیمگیری نیست
لکان تأکید میکند که اگر هدف نهایی تصمیمگیری باشد، لزوماً نیازی به یک Probability نرمالشده نداریم. اگر فقط بخواهیم بهترین تصمیم را انتخاب کنیم، مقایسهی Energyها میتواند کافی باشد.
در نگاه لکان، مدلهای احتمالاتی را میتوان در چارچوب Energy-Based Models تفسیر کرد؛ نه اینکه هر EBM الزاماً یک مدل احتمالاتی نرمالشده باشد.
۵.۳ مسئلهی Label Bias
در برخی مدلهای گرافی با نرمالسازی داخلی، از جمله برخی مدلهای زنجیرهای، نرمالسازی محلی میتواند به Label Bias منجر شود؛ به این معنا که ساختار خروجیهایی با تعداد مسیرهای متفاوت ممکن است تحت تأثیر این نرمالسازی قرار گیرد.
رویکرد انرژیمحور با نرمالسازی دیرهنگام (Late Normalization) میتواند این محدودیت را کاهش دهد، زیرا ابتدا یک امتیاز یا Energy برای کل ساختار تعریف میشود و normalization، در صورت نیاز، در سطح کلی انجام میشود.
بخش ششم: EBM برای توالیها و خروجیهای ساختیافته
۶.۱ مدلهای خطی ساختیافته
در مسائلی مثل برچسبگذاری توالی (Sequence Labeling)، خروجی Y یک توالی از برچسبهاست. انرژی را میتوان، در یک مدل خطی نسبت به پارامترها، بهصورت زیر نوشت:
که در آن F(X,Y) بردار ویژگیهاست. مدلهایی مانند CRF، SVMM و MMMN را میتوان در چارچوب گستردهی Energy-Based Learning تفسیر کرد.
۶.۲ مدلهای غیرخطی گرافمحور
میتوان فاکتورها را با شبکههای عصبی ساخت. این کار به مدل اجازه میدهد روابط غیرخطی و پیچیدهتری را یاد بگیرد و در مسائل ساختیافته، بخشهای مختلف گراف را با شبکههای یادگیری عمیق مدل کند.
۶.۳ شبکههای مبدل گراف (Graph Transformer Networks)
GTN در چارچوب مورد بحث لکان و همکاران، یک معماری سلسلهمراتبی است که در آن:
- گرافها بهعنوان ساختار داده استفاده میشوند.
- هر ماژول یک گراف میگیرد و میتواند گراف دیگری تولید کند.
- پارامترها با back-propagation و بهینهسازی گرادیانی، با استفاده از ساختارهای گرافی و trellis، آموزش میبینند.
مثال: در تشخیص جملهی دستنویس، تصویر میتواند ابتدا به یک گراف تقسیمبندی و سپس به گرافهای تفسیری بالاتر تبدیل شود و با الگوریتمهایی مانند Viterbi بهترین مسیر پیدا شود.
بخش هفتم: نگاه عملی — از EBM تا JEM
۷.۱ چرا EBM در عمل میتواند دشوار باشد؟
EBM از نظر تئوری بسیار انعطافپذیر است، اما در عمل:
- آموزش میتواند حساس باشد.
- MCMC میتواند پرهزینه باشد.
- هایپرپارامترها اهمیت زیادی دارند.
- sampling یا optimization ممکن است ناپایدار شود.
۷.۲ نمونهگیری با Langevin Dynamics
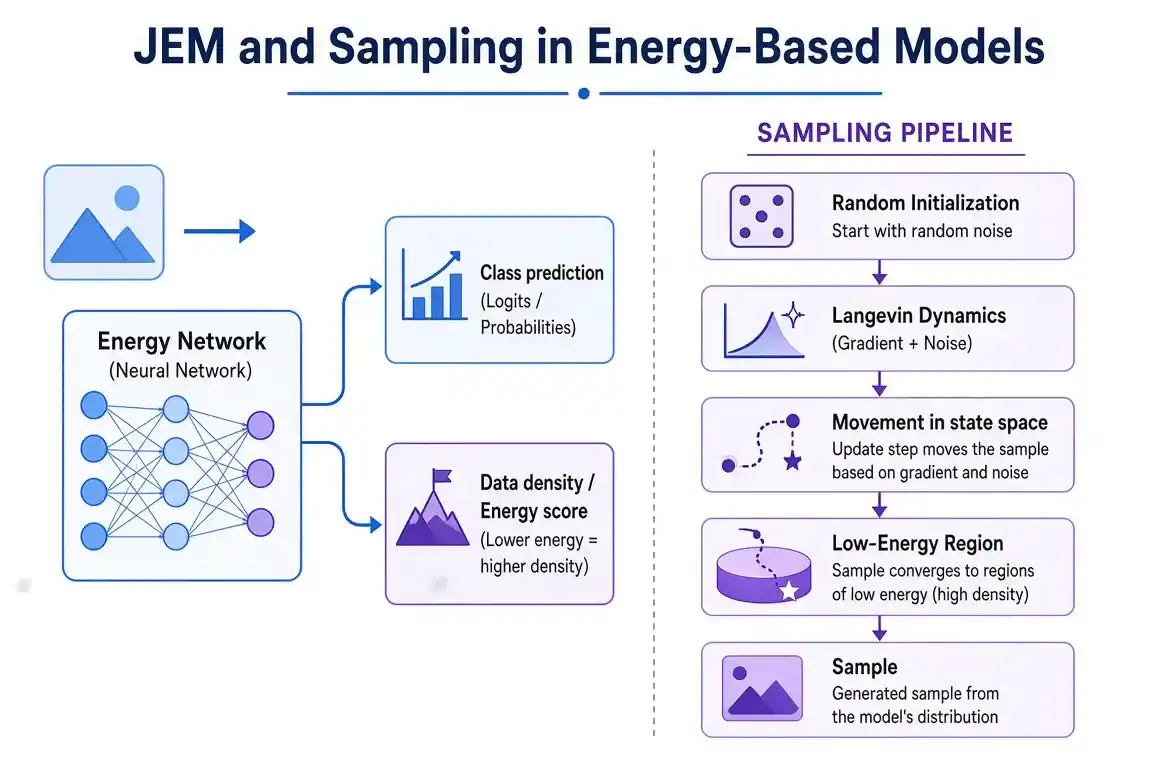
برای تولید sample از یک EBM مولد میتوان از MCMC و روشهایی مانند Langevin Dynamics استفاده کرد:
↓
Energy Model
↓
Gradient + Noise
↓
حرکت در فضای حالت
↓
Low-Energy Region
↓
Sample
Langevin Dynamics فقط gradient descent نیست؛ یک مؤلفهی تصادفی نیز دارد و به همین دلیل در چارچوب MCMC قرار میگیرد.
۷.۳ بافر نمونهگیری (Sampling Buffer)
برای کاهش هزینهی sampling، در برخی پیادهسازیهای عملی مانند JEM میتوان نمونههای قبلی را در یک Replay Buffer نگه داشت و از آنها بهعنوان نقطهی شروع زنجیرههای بعدی استفاده کرد.
در برخی تنظیمات JEM، احتمال بازآغاز تصادفی حدود ۵٪ در نظر گرفته شده است؛ این یک راهبرد پیادهسازی در آن تنظیم مشخص است، نه تعریف عمومی EBM.
۷.۴ JEM — مدل انرژی مشترک
JEM (Joint Energy Model) ایدهای از کار Grathwohl و همکاران است که نشان میدهد یک classifier میتواند بهگونهای بازتفسیر شود که علاوه بر مدلکردن P(Y|X)، یک Joint Energy Model برای P(X,Y) نیز فراهم کند.
├── Class
└── Data Density
در JEM، همان شبکه هم برای discriminative modeling و هم برای generative energy-based modeling مورد استفاده قرار میگیرد.
آموزش آن نیز دو جنبه دارد:
- Classification Loss با Cross Entropy
- Generative Maximum Likelihood با گرادیان تقریبی مبتنی بر SGLD / MCMC
بنابراین بهتر است بخش دوم را مستقیماً «Contrastive Divergence Loss» ننامیم؛ چون در JEM، محاسبهی likelihood generative با MCMC/SGLD تقریب زده میشود.
برای بررسی پیوند میان EBM، JEPA، متغیرهای پنهان و ایدههای بعدی لکان میتوانید مقالهی مدلهای انرژیمحور (EBM) و JEPA در نگاه یان لوکان را نیز مطالعه کنید.
بخش هشتم: تشخیص ناهنجاری و تولید
۸.۱ تشخیص ناهنجاری (Anomaly Detection)
در یک EBM که واقعاً برای مدلکردن distribution داده آموزش دیده باشد:
→ سازگاری بیشتر با Distribution مدل
Energy بالا
→ ناسازگاری بیشتر با Distribution مدل
بنابراین Energy میتواند بهعنوان یک score برای تشخیص نمونههای نامعمول یا Out-of-Distribution مورد استفاده قرار گیرد؛ اما این رابطه یک قانون مطلق برای همهی EBMها نیست.
۸.۲ تولید (Generation)
↓
Langevin / MCMC
↓
Energy ↓
↓
Sample
در این حالت Energy Model میتواند بهصورت غیرمستقیم نقش یک مولد را ایفا کند. خود مدل تصویر را مستقیماً تولید نمیکند؛ بلکه landscapeی تعریف میکند که sampler را به سمت نواحی کمانرژی هدایت میکند.
بخش نهم: جمعبندی — داستان EBM در یک نگاه
X → Y ؟
↓
بهجای اینکه مستقیماً Y را بسازیم،
برای هر X,Y یک Energy تعریف میکنیم.
↓
E(Y, X)
↓
کمترین Energy = بهترین پاسخ
↓
حالا باید Energy را یاد بگیریم.
↓
Loss Function
↓
Correct → Energy پایینتر
Wrong → Energy بالاتر
↓
اما اگر بعضی متغیرها را نبینیم؟
↓
Latent Variable Z
↓
اگر پاسخها ساختاری و خیلی زیاد باشند؟
↓
Factor Graph
↓
اگر sequence باشند؟
↓
Structured EBM
↓
اگر پیچیدهتر شوند؟
↓
Neural Networks + Graphs + GTN
↓
و اگر محاسبه دقیق سخت باشد؟
↓
Approximate Inference / Sampling
کلام آخر: چرا EBM مهم است؟
EBM یک چارچوب عمومیتر از مدلهای احتمالاتی است. در آن:
- لازم نیست برای تصمیمگیری حتماً مدل را به یک Probability نرمالشده تبدیل کنیم.
- میتوانیم از تابع Energy برای بیان سازگاری configurationها استفاده کنیم.
- میتوانیم متغیرهای پنهان را وارد مدل کنیم.
- میتوانیم چند حالت ممکن برای یک ورودی را نمایش دهیم.
- میتوانیم از inference و sampling برای جستوجو در فضای حالت استفاده کنیم.
- و در مدلهایی مانند JEM، یک شبکه میتواند همزمان نقش discriminative و energy-based داشته باشد.
«همه مدلها غلط هستند، اما برخی مفیدند.» — جورج باکس
EBM به ما میگوید: بهجای اصرار بر تولید مستقیم یک پاسخ، به سازگاری فکر کنیم؛ بهجای اینکه همیشه از ابتدا Probability بسازیم، میتوانیم ابتدا Energy را مدل کنیم؛ و بهجای فرض یک پاسخ یکتا، میتوانیم فضای پاسخهای ممکن را در نظر بگیریم.
از اینجا مسیر به ایدههای بزرگتری مانند Latent Variable، Multiple Prediction، World Model و JEPA باز میشود. EBM نه یک مدل خاص، بلکه یک چارچوب و زبان مشترک برای بیان سازگاری، استنتاج و تصمیمگیری است.
برای قرار دادن EBM در زمینهی گستردهتر هوش خودمختار و World Model، میتوانید معماری هوش خودمختار از دیدگاه یان لوکان و فلسفه World Model و نگاه یان لوکان به هوش را نیز بخوانید.
پرسشهای متداول درباره EBM، Latent Variable، JEM و JEPA
مدل انرژیمحور (EBM) چیست؟
مدل انرژیمحور برای configurationهای مختلف یک مقدار انرژی تعریف میکند. در این چارچوب، انرژی پایینتر به معنی سازگاری بیشتر configuration با مدلی است که یاد گرفته شده است و انرژی بالاتر سازگاری کمتر را نشان میدهد.
ایدهی اصلی تابع انرژی در EBM چیست؟
تابع انرژی یک configuration مانند جفت ورودی و خروجی را به یک مقدار اسکالر نگاشت میکند. سپس میتوان بهجای تولید مستقیم یک پاسخ، configurationای با کمترین انرژی را در فضای پاسخ جستوجو کرد.
استنتاج در مدلهای انرژیمحور چگونه انجام میشود؟
در سادهترین حالت، استنتاج به معنای یافتن خروجیای است که تابع انرژی را کمینه کند. در فضاهای بزرگ یا ساختیافته ممکن است از الگوریتمهای دقیق، Dynamic Programming یا روشهای تقریبی برای انجام این جستوجو استفاده شود.
Latent Variable یا متغیر پنهان در EBM چیست؟
متغیر پنهان متغیری است که مستقیماً مشاهده یا برچسبگذاری نشده، اما میتواند ساختار پنهان مسئله را توضیح دهد. در EBM میتوان متغیرهای پنهان را وارد تابع انرژی کرد و در زمان استنتاج آنها را بهینه یا حاشیهسازی کرد.
تفاوت EBM با مدلهای احتمالاتی چیست؟
مدل احتمالاتی بهصورت صریح یک توزیع احتمال نرمالشده تعریف میکند، در حالی که EBM میتواند بر بیان سازگاری نسبی از طریق Energy تمرکز کند و برای برخی وظایف تصمیمگیری الزاماً به یک Probability نرمالشده نیاز ندارد.
Free Energy در EBM دارای متغیر پنهان چه نقشی دارد؟
Free Energy راهی برای درنظرگرفتن مجموعهای از حالتهای ممکن متغیر پنهان است، بهجای اینکه فقط یک حالت خاص انتخاب شود. در شرایط و حدود مناسب، این کمیت با حاشیهسازی و کمینهسازی روی متغیرهای پنهان ارتباط پیدا میکند.
آیا هر EBM به MCMC یا Langevin Dynamics نیاز دارد؟
خیر. MCMC و Langevin Dynamics بهویژه زمانی مهم هستند که به sampling یا inference تقریبی نیاز باشد. در برخی مسائل ساختیافته میتوان از بهینهسازی یا الگوریتمهای دقیقتر استفاده کرد.
JEM چیست؟
JEM یا Joint Energy Model رویکردی است که یک classifier را بهعنوان مدلی انرژیمحور برای رابطهی مشترک میان ورودی و برچسب بازتفسیر میکند. بنابراین میتواند هم برای طبقهبندی و هم برای یک نگاه energy-based به چگالی داده مورد استفاده قرار گیرد.
رابطهی EBM و JEPA چیست؟
EBM یک چارچوب عمومی برای بیان سازگاری و Energy است، در حالی که JEPA یک معماری پیشبینیکنندهی joint-embedding است که بر پیشبینی در فضای نمایش تمرکز دارد. این دو در ایدههای گستردهتری مانند نمایشهای پنهان، پیشبینی و هوش خودمختار با یکدیگر ارتباط پیدا میکنند، اما یک مفهوم یکسان نیستند.
EBM، Latent Variable و World Model چگونه به یکدیگر مربوط میشوند؟
Latent Variable میتواند وضعیتهای پنهان را نمایش دهد و World Model تلاش میکند جنبههای معنادار محیط را نمایش و پیشبینی کند. فرمولبندی انرژیمحور یکی از راههای توصیف سازگاری میان وضعیتها یا configurationهای ممکن است. برای مطالعهی بیشتر میتوانید مقاله متغیرهای پنهان و مسیر یان لوکان به سوی هوش خودمختار و مقاله فلسفه World Model را بخوانید.
آیا Energy برای تشخیص ناهنجاری قابل استفاده است؟
در EBMهایی که واقعاً برای مدلکردن distribution یا سازگاری داده آموزش دیدهاند، Energy میتواند بهعنوان یک score برای تشخیص نمونههای نامعمول مورد استفاده قرار گیرد. بااینحال نباید برای هر EBM بدون توجه به روش آموزش و معنای تابع انرژی، مقدار بالا یا پایین را بهصورت خودکار معادل ناهنجاری یا طبیعیبودن دانست.
برای مطالعهی عمیقتر EBM از کجا شروع کنم؟
مسیر مناسب میتواند از تابع انرژی و استنتاج شروع شود، سپس به Latent Variable و Free Energy، مدلهای ساختیافته، sampling و JEM برسد و در ادامه به World Model، هوش خودمختار و JEPA متصل شود.
EBM با بحثهای گستردهتر دربارهی reasoning و یادگیری گرادیانی نیز ارتباط دارد. برای ادامهی این مسیر میتوانید مقاله استدلال و یادگیری گرادیانی در نگاه یان لوکان را مطالعه کنید.
برای قرار دادن EBM در نقشهی کلیتر هوش مصنوعی نیز مقالهی هوش مصنوعی را از چند زاویه میشود دید؟ نقطهی شروع مناسبی است.
واژهنامهی کلیدی EBM
| اصطلاح | معادل فارسی | توضیح کوتاه |
|---|---|---|
| Energy Function | تابع انرژی | تابعی که برای یک configuration میزان سازگاری را با یک عدد نشان میدهد |
| Inference | استنتاج | پیدا کردن configuration با کمترین Energy |
| Energy Landscape | چشمانداز انرژی | شکل تابع Energy روی فضای حالت |
| Loss Function | تابع زیان | تابعی برای شکلدهی مناسب Energy |
| Collapse | فروپاشی | حالتی که Energy نتواند تفاوت معناداری بین configurationها ایجاد کند |
| Margin | حاشیه | فاصلهی موردنیاز میان پاسخ درست و نادرست |
| Latent Variable | متغیر پنهان | متغیری که مقدار آن مستقیماً در آموزش مشاهده یا label نشده است |
| Free Energy | انرژی آزاد | تابعی که اثر مجموعهای از مقادیر متغیر پنهان را در بر میگیرد |
| Factor Graph | گراف عاملی | نمایش تجزیهی یک تابع انرژی به فاکتورهای کوچکتر |
| Most Offending Incorrect Answer | بدترین پاسخ نادرست | پاسخ نادرستی که کمترین Energy را در میان پاسخهای نادرست دارد |
| NLL | لگاریتم درستنمایی منفی | Loss احتمالاتی مبتنی بر likelihood |
| MCMC | زنجیرهی مارکوف مونتکارلو | خانوادهای از روشهای نمونهگیری |
| Langevin Dynamics | دینامیک لانژوین | روش MCMC مبتنی بر گرادیان و نویز تصادفی |
| SGLD | گرادیان تصادفی لانژوین | گونهای از Langevin Dynamics برای sampling |
| Replay Buffer | بافر بازپخش | نگهداری نمونههای قبلی برای شروع samplingهای بعدی |
| JEM | Joint Energy Model | تفسیر یک classifier بهعنوان مدل انرژی مشترک |
| GTN | Graph Transformer Network | معماری سلسلهمراتبی مبتنی بر گراف در چارچوب مدلهای ساختیافته |
| CRF | میدان تصادفی شرطی | مدل احتمالاتی ساختیافته |
| SVMM | ماشین مارکوف بردار پشتیبان | مدل ساختیافته مبتنی بر margin |
| MMMN | Maximum Margin Markov Network | مدل مارکوفی با آموزش مبتنی بر margin |
| Perceptron Loss | زیان پرسپترون | زیان مقایسهای بدون margin صریح |
| Hinge Loss | زیان لولایی | زیان مبتنی بر margin |
| Square-Square Loss | زیان مربع-مربع | یکی از توابع زیان بررسیشده در چارچوب EBM |
| Square-Exponential Loss | زیان مربع-نمایی | یکی از توابع زیان بررسیشده در چارچوب EBM |
منابع و مطالعه بیشتر
- LeCun, Y., Chopra, S., Hadsell, R., Ranzato, M. A., & Huang, F. J. (2006). A Tutorial on Energy-Based Learning. In Predicting Structured Data. MIT Press. https://yann.lecun.org/exdb/publis/pdf/lecun-06.pdf
- Dawid, A., & LeCun, Y. (2024). Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence. Journal of Statistical Mechanics: Theory and Experiment, 2024, 104011. DOI: 10.1088/1742-5468/ad292b
- Grathwohl, W., Wang, K.-C., Jacobsen, J.-H., Duvenaud, D., Norouzi, M., & Swersky, K. (2020). Your Classifier is Secretly an Energy Based Model and You Should Treat it Like One. ICLR. https://arxiv.org/abs/1912.03263
- Ha, D., & Schmidhuber, J. (2018). World Models. arXiv preprint.
- Hafner, D., et al. (2019). Learning Latent Dynamics for Planning from Pixels. ICML.
- Assran, M., et al. (2023). Self-Supervised Learning From Images With a Joint-Embedding Predictive Architecture. CVPR.
- Kingma, D. P., & Welling, M. (2014). Auto-Encoding Variational Bayes. ICLR.
این مقاله تلاشی است برای روایت داستان EBM از نگاه من؛ داستانی که از یک عدد ساده برای سنجش سازگاری شروع میشود و به استنتاج، متغیرهای پنهان، sampling، مدلسازی ساختیافته و در نهایت به ایدههای گستردهتری مانند World Model و JEPA میرسد.