چرا این یادداشت را نوشتم؟
هر بار که درباره هوش مصنوعی صحبت میکنیم، همه فکر میکنیم داریم درباره یک چیز حرف میزنیم. اما واقعیت این است که هوش مصنوعی مثل یک منشور است. هرکس از زاویهای به آن نگاه میکند، چیز دیگری میبیند.
یک مهندس نرمافزار به معماری مدلها فکر میکند. یک فیلسوف به این سوال که «آیا ماشین میتواند فکر کند؟» یک سرمایهگذار هم فقط به دنبال کاربردهای پولساز است. من تلاش کردهام در این یادداشت، هوش مصنوعی را از چند زاویهی مختلف بررسی کنم؛ نه برای اینکه شما را گیج کنم، بلکه برای اینکه یک نقشهی ذهنی خوب به شما بدهم.
۱. سطح توانایی: از یک دستیار ساده تا خدای دیجیتال
این سادهترین راه برای دستهبندی هوش مصنوعی است: چه کارهایی از دستش برمیآید؟
هوش مصنوعی محدود (ANI)
جایی که الان هستیم. سیستمهایی که در یک کار خاص عالی هستند، اما هیچچیزِ دیگر را بلد نیستند. مثلاً ChatGPT یک شاعر خوب است، اما اگر از او بپرسید الان ساعت چند است، هیچنمیداند. چون فقط متن بلد است، نه «حال و هوای» جهان را.
هوش مصنوعی عمومی (AGI)
این همان رویایی است که خیلیها دنبالش هستند. ماشینی که مثل یک انسان، هر کاری را بفهمد و انجام دهد. فعلاً در حد فیلمهای علمی-تخیلی و آزمایشگاههای پژوهشی است.
ابر هوش مصنوعی (ASI)
از ما باهوشتر. خیلی باهوشتر. این دیگر حتی یک ابزار نیست؛ یک موجودیت است. هنوز دربارهاش بیشتر هشدار میدهند تا اینکه تلاش کنند بسازندش.
💡 بهنظرم مهمترین نکته این است
خیلی از شرکتها دوست دارند محصولشان را «هوش عمومی» بنامند، اما در واقع همان ANI پیشرفته است. این دستهبندی بیشتر به ما جهت میدهد تا اینکه روش ساخت را نشان دهد.
۲. پارادایم ساخت: هوش را چطور میسازیم؟
اینجا بحث سر «روش» است. هوش مصنوعی را با چه رویکردی میسازیم؟
هوش نمادین (Symbolic AI)
قدیمیترین روش. مثل ریاضیات یا منطق. به ماشین یک سری قانون میدهیم و او طبق آنها تصمیم میگیرد. مثلاً میگوییم «همه انسانها میمیرند» و «سقراط انسان است»، پس ماشین نتیجه میگیرد که «سقراط میمیرد». این روش در کارهای حقوقی و پزشکی قانونمحور خوب است، اما وقتی با دنیای پیچیدهی واقعی روبرو میشود، کم میآورد.
یادگیری ماشین (Machine Learning)
اینجا انقلاب رخ داد. به جای قانون نوشتن، به ماشین کلی داده میدهیم و میگوییم خودش الگوها را پیدا کند. این روش خیلی موفقتر بود، چون دنیا پر از استثناست و نمیشود برای همهچیز قانون نوشت.
روشهای الهامگرفته از طبیعت
مثل الگوریتمهای فرگشتی (Evolutionary) یا هوش جمعی (Swarm). اینها به جای تقلید از مغز، از طبیعت الگو میگیرند؛ مثلاً از رفتار مورچهها یا پرندگان برای پیدا کردن بهترین مسیر.
هوش ترکیبی (Hybrid AI)
روش غالب امروز. چون متوجه شدهایم که فقط داده کافی نیست. باید قواعد منطقی را هم با یادگیری ماشین ترکیب کنیم تا نتیجهی بهتری بگیریم.
💡 نکتهی خودم
یادگیری ماشین امروز همهچیز را در بر گرفته، اما تازه داریم میفهمیم که برای کارهای دقیق، به همان منطق قدیمی هم نیاز داریم.
۳. روش یادگیری: ماشین چطور از داده تغذیه میکند؟
حالا که به یادگیری ماشین رسیدیم، ببینیم خودِ یادگیری چند جور است:
- یادگیری نظارتشده (Supervised): مثل یک دانشآموز که با پاسخنامه تمرین میکند. به ماشین هزاران عکس گربه با برچسب «گربه» نشان میدهیم تا یاد بگیرد. دقیق است، اما هزینهی برچسبزنی بالاست.
- یادگیری بدون نظارت (Unsupervised): ماشین را توی اتاقی پر از اشیاء مختلف میگذاریم و میگوییم خودش اشیاء شبیههم را کنار هم بچیند. خودش الگو را کشف میکند.
- یادگیری خودنظارت (Self-Supervised): جذابترین روش امروز. خودِ داده، برای خودش سوال تولید میکند. مثلاً در مدلهای زبانی، از ماشین میخواهیم کلمهی بعدی را حدس بزند؛ خودِ کلمهی بعدی، پاسخنامه است. این روش پایه و اساس مدلهای بزرگی مثل GPT است.
- یادگیری تقویتی (Reinforcement): مثل آموزش سگ. اگر کار درست را انجام دهد، جایزه میگیرد. این روش در بازیهای کامپیوتری و رباتیک معجزه میکند.
- یادگیری پیوسته (Continual): توانایی یادگیری تدریجی بدون فراموشی مطالب قبلی. این نقطهضعف بزرگ شبکههای عصبی امروز است و پژوهشگران زیادی رویش کار میکنند.
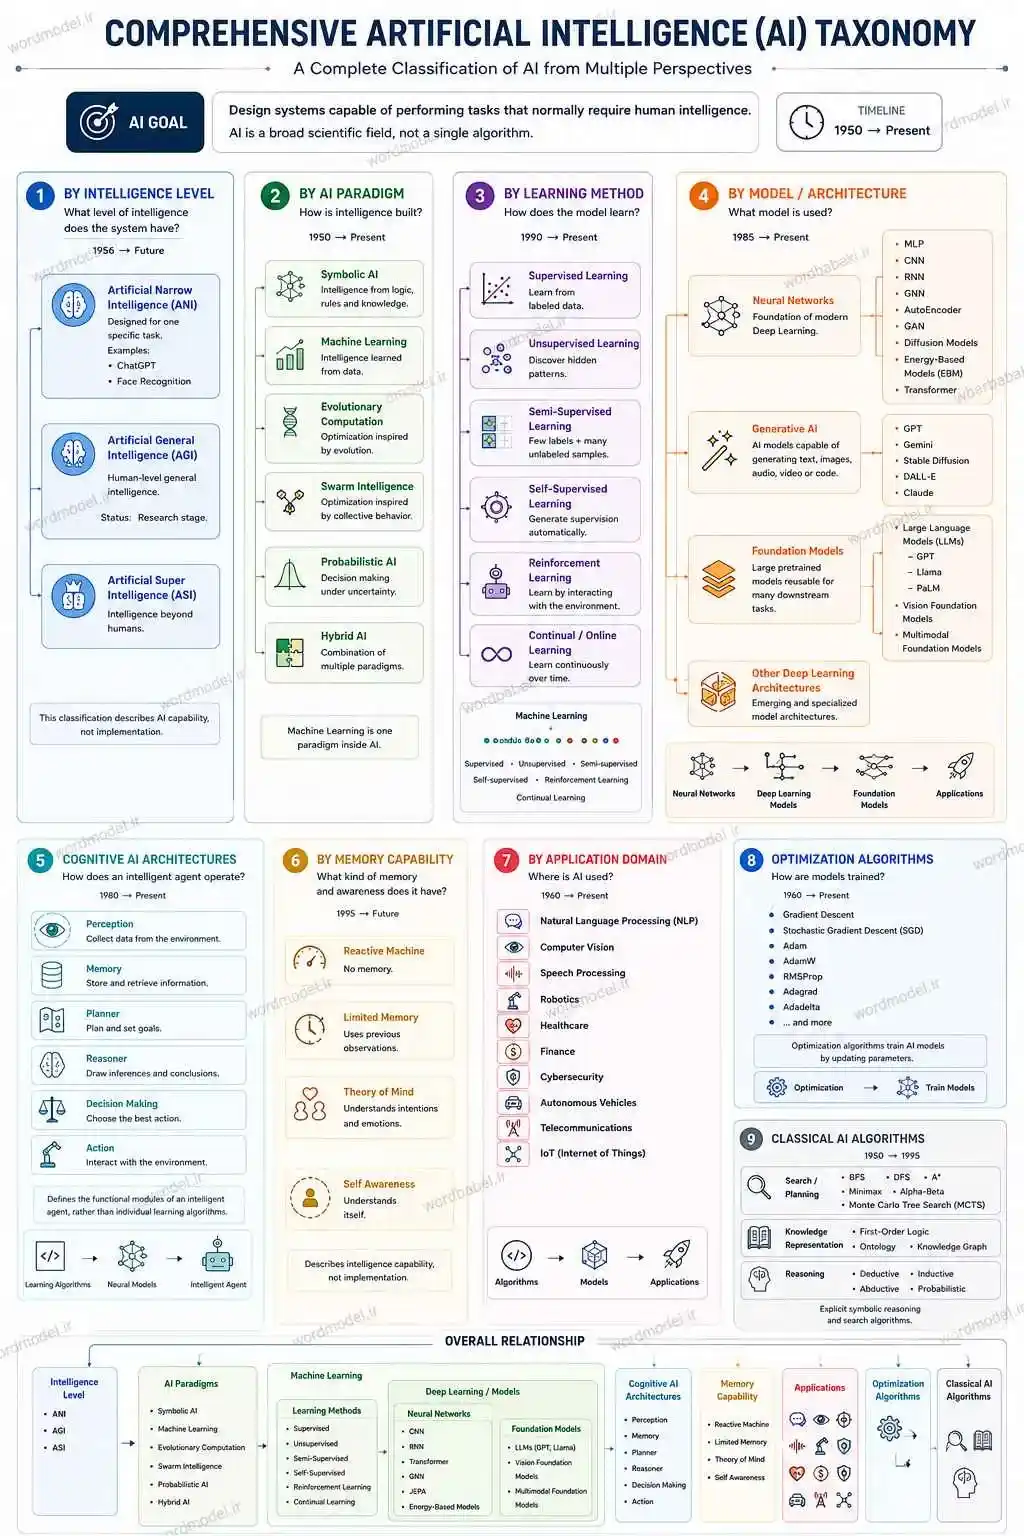
۴. معماری مدل: مغز ماشین از چه جنسی است؟
این بخش کمی فنیتر میشود، اما سادهاش میکنم:
- شبکههای عصبی کلاسیک: مثل پرسپترون (MLP) برای دادههای ساده، یا CNN برای تصاویر، یا RNN برای متن و صدا. اینها پایههای اولیه بودند.
- ترنسفورمر (Transformer): این همان تحول بزرگ است. معماریای که به مدل اجازه میدهد به همهی کلمات ورودی همزمان نگاه کند و ارتباط بینشان را پیدا کند. تمام مدلهای معروف امروز (GPT، Gemini، Llama) از همین معماری استفاده میکنند.
- مدلهای مولد (Generative AI): اینها محتوای جدید میسازند؛ متن، تصویر، صدا، فیلم. از GANها و AutoEncoderهای قدیمی تا مدلهای Diffusion که امروز کیفیت تصویر را به سطح باورنکردنی رساندهاند.
- مدلهای بنیادین (Foundation Models): بزرگترین تغییر استراتژیکِ سالهای اخیر. مدلی که روی همهی دادههای ممکن (مثلاً کل اینترنت) آموزش دیده و بعد با کمی تغییر، برای هزاران کاربرد مختلف قابل استفاده است.
💡 یک نکتهی مهم
معماری مدل با روش یادگیری فرق دارد. ترنسفورمر یک معماری است؛ میتوانید آن را با روش نظارتشده یا خودنظارت آموزش دهید.
۵. معماری شناختی: یک عامل هوشمند چطور کار میکند؟
اگر به ماشین فقط به چشم یک شبکهی عصبی نگاه کنیم، چیزهای زیادی را از دست میدهیم. هر عامل هوشمندی (مثل یک ربات یا یک دستیار مجازی) از چند بخش تشکیل شده است:
- ادراک (Perception): دریافت اطلاعات از محیط (متن، تصویر، صدا).
- حافظه (Memory): نگهداشتن اطلاعات قبلی.
- برنامهریز (Planner): تصمیمگیری دربارهی قدمهای بعدی.
- استدلالگر (Reasoner): نتیجهگیری از اطلاعات.
- تصمیمگیرنده (Decision Maker): انتخاب بهترین کار.
- عملکننده (Action): انجام کار در دنیای واقعی.
در این نگاه، یک مدل زبانی مثل ChatGPT فقط بخش «ادراک و استدلال» است. برای اینکه تبدیل به یک عامل واقعی شود، به حافظه و برنامهریز نیاز دارد. به همین دلیل است که این روزها بحث «عاملهای هوشمند» (Agentic AI) حسابی داغ است.
برای ادامهی این بحث، مطالعهی معماری هوش خودمختار از دیدگاه یان لوکان میتواند این نگاه را عمیقتر کند.
۶. حافظه: از یک واکنش ساده تا خودآگاهی
این دستهبندی به من میگوید که یک سیستم چقدر از گذشتهاش استفاده میکند:
- ماشین واکنشگرا: پینگپنگ بازی میکند، اما ضربهی قبلی را به خاطر نمیآورد.
- حافظهی محدود: خودروهای خودران سه ثانیهی گذشته را نگه میدارند تا تصادف نکنند.
- نظریهی ذهن: ماشین میفهمد که من چه چیزی میدانم و چه چیزی نمیدانم. این مرحله خیلی به درک اجتماعی نزدیک است و هنوز به بلوغ نرسیده.
- خودآگاهی: ماشین از وجود خودش آگاه است. اینجا دیگر وارد دنیای علمتخیلی میشویم.
۷. کاربردها: هوش مصنوعی کجاها به کار میرود؟
جالب است که یک معماری واحد (ترنسفورمر) در همهی این حوزهها نفوذ کرده:
- پردازش زبان طبیعی (NLP): چتباتها، ترجمهی ماشینی، تحلیل نظرات مشتریان.
- بینایی کامپیوتر (CV): تشخیص چهره، خواندن نوشتهی روی تابلوها، کنترل کیفیت در کارخانهها.
- رباتیک و خودروهای خودران: جایی که هوش با فیزیک برخورد میکند.
- پزشکی و داروسازی: مثل AlphaFold که ساختار پروتئینها را کشف کرد و دنیای زیستشناسی را متحول ساخت.
- امنیت و مالی: تشخیص کلاهبرداری در کسری از ثانیه.
۸. بهینهسازی: موتورِ پشت صحنهی یادگیری
بیاینکه بهینهسازی داشته باشیم، مدلها هیچچیز یاد نمیگیرند. اینجا ریاضیات محض است. از الگوریتمهای ساده مثل شیب نزولی (SGD) تا روشهای پیشرفتهتر مثل Adam که امروز استاندارد طلایی محسوب میشود. انتخاب بهینهسازِ درست، گاهی از انتخاب معماریِ درست هم مهمتر است.
این موضوع به بحث استدلال و یادگیری گرادیانی نیز پیوند پیدا میکند.
۹. هوش مصنوعی کلاسیک: ریشههایی که نباید فراموش شوند
قبل از اینکه دادههای بزرگ همهچیز را تغییر دهد، هوش مصنوعی با جستجو و منطق سر و کار داشت:
- الگوریتمهای جستجو: مثل BFS، DFS، A* و MCTS که در بازی شطرنج قهرمان میساختند.
- بازنمایی دانش: مثل گرافهای دانش و هستیشناسی که هنوز در موتورهای جستجوی سازمانی استفاده میشوند.
- استدلال: استقرا، قیاس و استنتاج که پایههای «قابل تفسیر بودن» مدلهای امروزی هستند.
💡 بهنظرم جالب است که
این روزها دوباره به سمت این روشها برمیگردیم؛ چون مدلهای بزرگ در کارهای ریاضی و منطقی ضعیف عمل میکنند و مجبوریم دوباره از «منطقِ کلاسیک» کمک بگیریم.
جمعبندی: این درخت دانش، نقشهی راه من است
اگر این مقاله را با یک نگاه کلی مرور کنید، میبینید که هیچ پروژهی هوش مصنوعیای فقط روی یک شاخه از این درخت کار نمیکند. مثلاً برای ساخت یک چتبات پزشکی، شما باید:
- از یادگیری ماشین استفاده کنید.
- با یادگیری خودنظارت و معماری ترنسفورمر مدل را بسازید.
- از حافظهی محدود و بهینهساز Adam بهره ببرید.
- و در نهایت، با تزریق قواعد منطقی (همان هوش نمادین قدیمی) جلوی اشتباهات فاحش را بگیرید.
🎯 سخن آخر
هوش مصنوعی یک ابزار نیست؛ یک جهان است. هر دستهبندی، یک زاویهی جدید به من نشان میدهد. درک این ابعاد برای من نه یک کار آکادمیک، که یک نیاز روزمره و استراتژیک شده است. امیدوارم این نقشهی ذهنی برای شما هم مفید باشد.
پرسشهای متداول درباره ابعاد و دستهبندی هوش مصنوعی
هوش مصنوعی را از چه ابعادی میتوان دستهبندی کرد؟
میتوان هوش مصنوعی را از چند زاویه بررسی کرد؛ از جمله سطح توانایی مانند ANI، AGI و ASI، پارادایم ساخت مانند هوش نمادین و یادگیری ماشین، روش یادگیری، معماری مدل، معماری شناختی، حافظه، کاربردها، بهینهسازی و روشهای کلاسیک هوش مصنوعی.
تفاوت ANI، AGI و ASI چیست؟
ANI یا هوش مصنوعی محدود برای مجموعهای مشخص از وظایف طراحی میشود. AGI به مفهوم سامانهای با توانایی عمومی و گسترده شبیه انسان اشاره دارد و ASI به هوشی فراتر از تواناییهای انسان اشاره میکند. این سه مفهوم بیشتر یک دستهبندی بر اساس سطح توانایی هستند تا توضیحی درباره معماری یا روش آموزش.
آیا Transformer یک روش یادگیری است؟
خیر. Transformer یک معماری مدل است. روش یادگیری و معماری مدل دو موضوع متفاوت هستند و یک معماری میتواند با شیوههای مختلف آموزش داده شود.
تفاوت پارادایم ساخت AI با روش یادگیری چیست؟
پارادایم ساخت به رویکرد کلی برای ساخت سیستم هوشمند اشاره دارد؛ برای مثال هوش نمادین، یادگیری ماشین یا ترکیب روشها. روش یادگیری مشخص میکند مدل چگونه از داده یا تعامل با محیط یاد میگیرد؛ برای مثال یادگیری نظارتشده، خودنظارت یا تقویتی.
معماری شناختی در یک عامل هوشمند چه نقشی دارد؟
معماری شناختی به اجزای عملکردی یک عامل هوشمند مانند ادراک، حافظه، برنامهریزی، استدلال، تصمیمگیری و عمل اشاره میکند. این نگاه تنها به خود مدل عصبی محدود نیست و کل سامانه هوشمند را در نظر میگیرد.
آیا حافظه و خودآگاهی در هوش مصنوعی یکسان هستند؟
خیر. داشتن حافظه به معنی خودآگاهی نیست. حافظه به استفاده از اطلاعات گذشته مربوط است، در حالی که خودآگاهی مفهومی بسیار قویتر درباره آگاهی سامانه از وجود و وضعیت خودش است.
چرا هوش مصنوعی کلاسیک هنوز اهمیت دارد؟
روشهایی مانند جستجو، بازنمایی دانش و استدلال همچنان برای برخی مسائل ارزشمند هستند. این روشها میتوانند در کنار روشهای یادگیریمحور قرار بگیرند و برای طراحی سامانههایی با ترکیبی از یادگیری و منطق مورد استفاده قرار گیرند.
مدلهای EBM و JEPA در این دستهبندی کجا قرار میگیرند؟
EBM و JEPA نمونههایی هستند که نشان میدهند برای توصیف یک سیستم هوش مصنوعی، تنها دانستن سطح توانایی یا کاربرد کافی نیست و باید به معماری، نمایشهای درونی، پیشبینی و هدف یادگیری نیز توجه کرد. برای مطالعهی عمیقتر میتوانید مقاله EBM و JEPA در نگاه یان لوکان را بخوانید.
Latent Variable یا متغیر پنهان چه ارتباطی با این بحث دارد؟
متغیر پنهان بیشتر به نحوهی نمایش اطلاعات و مدلسازی ساختارهای غیرمستقیم در یک سیستم مربوط میشود و در نتیجه یک محور متفاوت از دستهبندیهایی مانند ANI یا Transformer است. این مفهوم را میتوان در پیوند با معماریهای مدل و World Model بررسی کرد.
آیا یک پروژه هوش مصنوعی میتواند همزمان در چند دسته قرار بگیرد؟
بله. این یکی از نکات اصلی این نقشهی ذهنی است. یک سیستم میتواند همزمان از نظر سطح توانایی، معماری مدل، روش یادگیری، حافظه، کاربرد و روش بهینهسازی ویژگیهای متفاوتی داشته باشد و بنابراین یک دستهبندی واحد برای توصیف کامل آن کافی نیست.
برای مطالعهی عمیقتر دربارهی رابطه میان مدلهای انرژی و معماریهای جدیدتر، میتوانید مجموعه مقالات مرتبط با EBM و JEPA را نیز دنبال کنید.
همچنین برای بررسی جنبههای شناختی و فلسفیتر این موضوع، ریشههای شناختی دیدگاه یان لوکان و فلسفه World Model ادامهی مناسبی برای این مسیر هستند.
منابع و مطالعه بیشتر
- Russell, S. J., & Norvig, P. (2021). Artificial Intelligence: A Modern Approach (4th ed.). Pearson.
- LeCun, Y., Bengio, Y., & Hinton, G. (2015). Deep learning. Nature, 521(7553), 436–444. https://doi.org/10.1038/nature14539
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. The MIT Press.
- Sutton, R. S., & Barto, A. G. (2018). Reinforcement Learning: An Introduction (2nd ed.). The MIT Press.
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. In Advances in Neural Information Processing Systems (NeurIPS 2017).
- LeCun, Y. (2022). A path towards autonomous machine intelligence. OpenReview. https://openreview.net/pdf?id=BZ5a1r-kVsf