مقدمه
در سالهای اخیر، پیشرفتهای چشمگیری در حوزه هوش مصنوعی، بهویژه در زمینه یادگیری عمیق و مدلهای زبانی بزرگ، حاصل شده است. موفقیت مدلهایی مانند GPT، سامانههای بینایی ماشین و بسیاری از الگوریتمهای یادگیری تقویتی نشان میدهد که روشهای مبتنی بر شبکههای عصبی توانستهاند دامنه وسیعی از مسائل را با دقت قابل توجهی حل کنند. با وجود این دستاوردها، همچنان این پرسش اساسی مطرح است که آیا چنین سیستمهایی واقعاً دارای «هوش» هستند یا صرفاً میتوانند الگوهای آماری بسیار پیچیده را یاد بگیرند و بازتولید کنند.
یان لکان (Yann LeCun) این پرسش را در چارچوب نقد خود بر وضعیت کنونی هوش مصنوعی مطرح میکند. از دیدگاه او، مسئله فقط قدرت پردازش، اندازه مدل یا حجم داده آموزشی نیست؛ بلکه به پارادایم یادگیری نیز مربوط میشود. به بیان دیگر، لکان بر این باور است که مسیر یادگیری ماشینهای امروزی با شیوهای که انسان و حیوانات هوشمند از جهان میآموزند تفاوتهای مهمی دارد. بنابراین، مسئله صرفاً یک مسئله مهندسی نیست و به پرسشهایی درباره شناخت، یادگیری و ماهیت هوش نیز مربوط میشود.
پارادایم غالب در هوش مصنوعی امروز
بخش بزرگی از موفقیتهای کنونی هوش مصنوعی بر روشهای بهینهسازی مبتنی بر گرادیان تکیه دارد؛ یعنی پارامترهای یک مدل بر اساس یک تابع هدف یا هزینه و با استفاده از گرادیان بهصورت تدریجی بهروزرسانی میشوند.
البته اهداف یادگیری در مدلهای زبانی، سامانههای بینایی و یادگیری تقویتی یکسان نیستند، اما در بسیاری از این سامانهها میتوان یک الگوی عمومی مشابه دید: مدل بر اساس وضعیت فعلی خود خروجی یا رفتار تولید میکند، عملکرد آن با یک هدف یا سیگنال بازخوردی ارزیابی میشود و سپس پارامترها برای بهبود عملکرد بهروزرسانی میشوند.
📐 از منظر ریاضی، ایده اصلی را میتوان اینگونه خلاصه کرد
«پارامترهای مدل را به گونهای تغییر بده که مقدار تابع هدف یا هزینه کاهش یابد.»
این فرایند میتواند بارها و بارها تکرار شود تا مدل به سطح عملکرد موردنظر برسد.
یادگیری تقویتی؛ تجربه بهجای پاسخ صحیح
در یادگیری تقویتی (Reinforcement Learning)، پاسخ صحیح از پیش برای هر وضعیت مشخص نشده است و عامل از طریق تعامل با محیط و دریافت بازخورد رفتاری خود را اصلاح میکند. عامل عملی را انتخاب میکند، پیامد آن را مشاهده میکند، پاداش یا جریمه دریافت میکند و سپس سیاست خود را بر اساس این بازخورد بهروزرسانی میکند.
🔄 چرخه یادگیری تقویتی
Action → Environment → Reward → Update
در بسیاری از تنظیمات یادگیری تقویتی، عامل برای کشف پیامد اقدامات خود به تعامل با محیط نیاز دارد. این وابستگی، بهویژه در روشهای model-free، میتواند موجب نیاز به تعداد زیادی آزمون و تعامل شود. خود لکان نیز model-free RL را از نظر Sample Efficiency، در مقایسه با یادگیری انسان و حیوانات، بسیار ناکارآمد توصیف میکند.
از دیدگاه لکان، مسئله در اینجا آن است که اگر یادگیری عمدتاً بر آزمونهای مستقیم و بازخوردهای محدود متکی باشد، عامل برای کشف بسیاری از روابط موجود در جهان مجبور به تجربه دوباره و دوباره پیامدهای واقعی خواهد شد. به باور او، بخش بزرگی از این یادگیری باید بتواند بدون انجام همه این آزمونهای پرهزینه، از طریق مشاهده و مدلسازی جهان صورت گیرد.
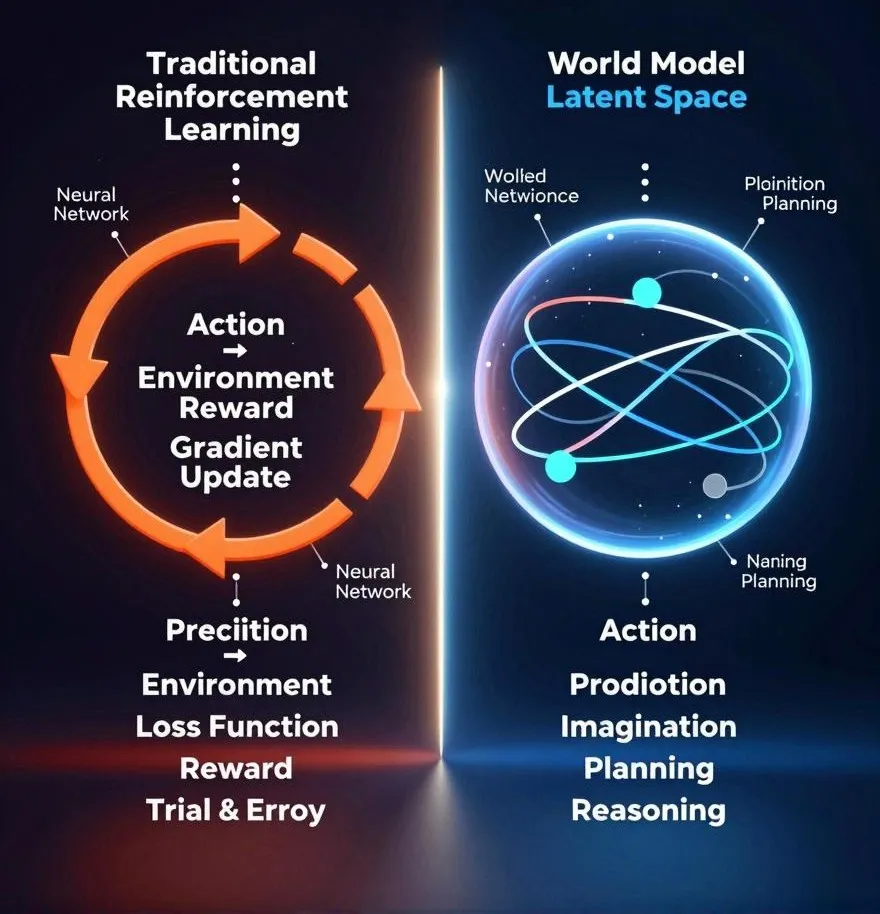
نقد نخست: وابستگی یادگیری به تعامل مستقیم با جهان
نخستین انتقاد لکان متوجه وابستگی شدید بسیاری از سامانههای یادگیری، بهویژه در تنظیمات model-free، به تعامل با محیط است. در چنین سامانههایی، عامل بخشی از دانش خود را از طریق انجام عمل و مشاهده پیامد آن به دست میآورد.
نقل به مضمون از دیدگاه لکان: تعامل با جهان واقعی پرهزینه و در برخی کاربردها خطرناک است؛ بنابراین یک عامل هوشمند باید تا حد امکان بتواند از طریق مشاهده و یادگیری یک مدل درونی از جهان، نیاز به آزمونهای مستقیم را کاهش دهد.
— بر اساس بحث لکان در A Path Towards Autonomous Machine Intelligence
لکان این موضوع را از منظر مقیاسپذیری یادگیری مهم میداند. در بسیاری از کاربردهای واقعی، تجربه مستقیم نهتنها زمانبر، بلکه پرهزینه یا بالقوه خطرناک است. به همین دلیل، یادگیری از مشاهده و پیشبینی پیامدها میتواند نقش مهمی در کاهش تعداد تعاملات ضروری با جهان داشته باشد.
نقد دوم: فقدان مدل جهان (World Model)
یکی از بنیادیترین مفاهیم در اندیشه لکان، «مدل جهان» (World Model) است. او در طرح خود بر این ایده تأکید میکند که عامل هوشمند باید نوعی نمایش درونی و قابل استفاده از نحوه تغییر جهان در اختیار داشته باشد.
از نگاه لکان، مسئله این نیست که هر سامانه امروزی الزاماً فاقد هرگونه بازنمایی از جهان است؛ بلکه نقد او متوجه این است که بسیاری از رویکردهای رایج، مدلسازی صریح و قابل استفاده از پویایی جهان را در مرکز فرایند یادگیری قرار نمیدهند. در نتیجه، یک سیستم ممکن است بتواند ارتباطهای آماری پیچیده میان ورودی، وضعیت و عمل را یاد بگیرد، بدون آنکه بتواند بهصورت مؤثر پیامدهای آینده را در یک مدل درونی شبیهسازی کند.
نقل به مضمون از لکان: یکی از مسیرهای دستیابی به هوش ماشین میتواند در توانایی انسان و حیوانات برای یادگیری مدلهای جهان باشد؛ یعنی مدلهای درونی که نحوه کارکرد جهان را توصیف میکنند.
— یان لکان، A Path Towards Autonomous Machine Intelligence
از این منظر، چیزی که ما «عقل سلیم» مینامیم تا حد زیادی به دانش ضمنی درباره نحوه رفتار اشیا، رویدادها و روابط علّی یا فیزیکی جهان وابسته است. چنین دانشی به عامل اجازه میدهد درباره آنچه محتمل، ممکن یا نامحتمل است پیشبینیهای بهتری داشته باشد.
نقد سوم: ناتوانی در شبیهسازی ذهنی آینده
یکی دیگر از تفاوتهای مورد تأکید لکان، توانایی پیشبینی پیامد اعمال پیش از اجرای آنهاست. انسان میتواند پیش از انجام یک عمل، سناریوهای مختلف را در ذهن خود تصور کند، پیامدهای احتمالی آنها را بسنجد و سپس تصمیم بگیرد.
لکان معتقد است یک عامل خودمختار نیز باید بتواند از مدل جهان خود برای پیشبینی وضعیتهای آینده استفاده کند. در این صورت، عامل میتواند بهجای اینکه برای هر گزینه حتماً آن را در جهان واقعی آزمایش کند، تعدادی از پیامدهای احتمالی را در فضای مدل داخلی خود بررسی کند.
در معماری پیشنهادی او، مدل جهان برای پیشبینی وضعیتهای احتمالی آینده و فراهمکردن بستری برای برنامهریزی و جستوجوی مسیرهای مختلف استفاده میشود. این ایده با مفهوم «عمل در جهان قبل از عمل واقعی» تفاوت دارد: ابتدا پیامدها در مدل پیشبینی میشوند و سپس یک تصمیم برای اجرا انتخاب میشود.
نقد چهارم: بهرهوری پایین در استفاده از داده
یکی از پیامدهای مستقیم وابستگی زیاد به تجربه، افزایش تعداد نمونهها و تعاملات موردنیاز برای یادگیری است. لکان بهطور مشخص بر این مسئله تأکید میکند که روشهای model-free RL، در مقایسه با یادگیری انسان و حیوانات، از نظر Sample Efficiency بسیار ناکارآمد هستند.
در بسیاری از کاربردهای واقعی، چنین میزان آزمون و خطایی امکانپذیر نیست. برای مثال، یک ربات نمیتواند برای یادگیری یک مهارت هر خطای فیزیکی را میلیونها بار تکرار کند و یک خودروی خودران نیز نمیتواند برای کشف پیامدهای خطرناک تصمیمهای خود منتظر وقوع تعداد زیادی تصادف باشد.
📊 بهرهوری یادگیری (Sample Efficiency)
از نگاه لکان، یکی از اهداف اصلی معماریهای مبتنی بر مدل جهان این است که حجم زیادی از دانش از طریق مشاهده و پیشبینی آموخته شود تا تعداد تعاملات مستقیم موردنیاز برای یادگیری مهارتها کاهش پیدا کند.
این دیدگاه، فاصله میان روشهای رایج یادگیری تقویتی model-free و شیوه یادگیری انسان و حیوانات را به یکی از مسائل مهم پژوهشی در مسیر هوش خودمختار تبدیل میکند.
نقد پنجم: وابستگی بیش از حد به سیگنال پاداش
در بسیاری از الگوریتمهای یادگیری تقویتی، پاداش نقش مهمی در هدایت فرایند یادگیری دارد. عامل بر اساس سیگنالهای مثبت یا منفی دریافتی از محیط، سیاست خود را اصلاح میکند.
لکان معتقد است این نوع سیگنال، بهتنهایی اطلاعات کافی برای یادگیری تمام ساختار پیچیده موردنیاز یک عامل هوشمند فراهم نمیکند. از دیدگاه او، پاداش یک سیگنال اسکالر و کماطلاعات است و نمیتواند جایگزین یادگیری گسترده درباره ساختار جهان شود.
نقل به مضمون از لکان: پاداش سیگنالی کماطلاعات است؛ بنابراین نباید انتظار داشت که یک سامانه پیچیده فقط با اتکا به پاداش، تمام دانش لازم برای رفتار هوشمند را یاد بگیرد.
— بر اساس بخش «Reward is not enough» در A Path Towards Autonomous Machine Intelligence
در طرح لکان، یادگیری مدل جهان از طریق پیشبینی میتواند بخش بسیار بزرگتری از پارامترهای سامانه را آموزش دهد، در حالی که پاداش یا هزینه ذاتی بیشتر برای هدایت رفتار، تعیین اهداف و ارزیابی مسیرهای آینده به کار میرود.
نقد ششم: محدودیت در استدلال و برنامهریزی
آخرین نقد مهم لکان به محدودبودن شکلهای استدلال و برنامهریزی در بسیاری از سامانههای موجود مربوط میشود. او استدلال میکند که برخی مدلهای فعلی در عمل عمدتاً نگاشتهایی از مشاهده به خروجی یا عمل ایجاد میکنند و در آنها امکان جستوجوی غنی بر سر تفسیرهای مختلف و مسیرهای متفاوت برای رسیدن به یک هدف محدود است.
در مقابل، عامل موردنظر لکان باید بتواند اهداف را در سطوح مختلف تعریف کند، مسیرهای جایگزین را بررسی کند، پیامدهای احتمالی هر مسیر را در مدل جهان پیشبینی کند و سپس توالی مناسبی از اقدامات را انتخاب کند.
در مقاله لکان، این نوع استدلال به مسئله جستوجو و کمینهسازی انرژی یا ارضای قیود برای یافتن ترکیبی مناسب از اعمال و متغیرهای نهفته مرتبط میشود. او همچنین اشاره میکند که نبود متغیرهای انتزاعی نهفته میتواند توانایی یک مدل برای بررسی تفسیرهای متعدد از یک ادراک و جستوجوی مسیر مناسب برای رسیدن به هدف را محدود کند.
جمعبندی
تحلیل دیدگاه یان لکان نشان میدهد که نقد او متوجه موفقیتهای مهندسی یادگیری عمیق نیست، بلکه به محدودیتهای یک پارادایم خاص از یادگیری و معماری شناختی مربوط میشود. از نگاه او، مسئله اصلی فقط افزایش دقت مدلها نیست؛ بلکه این است که چگونه میتوان سامانههایی ساخت که مانند موجودات هوشمند بتوانند جهان را مشاهده کنند، یک مدل درونی از آن بسازند و از آن مدل برای پیشبینی و تصمیمگیری استفاده کنند.
در این چارچوب، وابستگی زیاد برخی روشها به تعامل مستقیم، Sample Efficiency پایین در model-free RL، اتکای قابل توجه به سیگنال پاداش، نبود یک مدل جهان قابل استفاده، محدودیت در شبیهسازی آینده و دشواری استدلال و برنامهریزی، همگی به یک پرسش عمیقتر منتهی میشوند: آیا میتوان یادگیری را طوری سازمان داد که بخش عمدهای از دانش موردنیاز عامل، پیش از انجام همه اقدامات در جهان واقعی، از طریق مشاهده و پیشبینی آموخته شود؟
🎯 پیام کلیدی لکان
نسل بعدی هوش مصنوعی در چشمانداز لکان باید صرفاً به یادگیری نگاشتهای آماری اکتفا نکند، بلکه بتواند ساختار جهان را بیاموزد، وضعیتهای آینده را پیشبینی کند، سناریوهای مختلف را در مدل داخلی خود بررسی کند و پیش از تعامل با محیط، پیامد تصمیمهای خود را ارزیابی کند.
در این دیدگاه، مدل جهان یک مؤلفه جانبی نیست؛ بلکه بخشی مرکزی از معماری لازم برای دستیابی به یادگیری کارآمد، برنامهریزی و هوش خودمختار به شمار میرود.